Duplicate Content kann aus SEO-Sicht zum Problem werden, wenn Suchmaschinen eine Website und ihre URL-Struktur nicht eindeutig interpretieren können. Struktur und die richtige Auszeichnung der Website und ihrer Inhalte spielen dabei eine wichtige Rolle. Senden Weiterleitungen, Canonicals, hreflang-Tags oder Sitemaps widersprüchliche Signale, kann das die Indexierung und Sichtbarkeit beeinträchtigen.
In diesem Artikel erklären wir zunächst die wichtigsten Grundlagen zu Duplicate Content und zeigen anschließend anhand eines Praxiscases aus 2016, wie falsch umgesetztes HTTPS sowie widersprüchliche Canonicals und hreflang-Tags die Performance einer internationalen Website beeinflusst haben. Die technischen Rahmenbedingungen des Cases sind historisch, die zentralen SEO-Learnings sind bis heute relevant.
Was ist Duplicate Content?
Duplicate Content sind identische oder sehr ähnliche Inhalte, die unter mehreren URLs erreichbar sind. Dabei kann es sich um unterschiedliche URLs innerhalb einer Domain oder um Inhalte auf verschiedenen Domains handeln. Typische Beispiele sind HTTP- und HTTPS-Versionen einer Seite, URL-Parameter, Sortier- und Filterfunktionen oder regionale Varianten. Google fasst identische oder sehr ähnliche Seiten bei der Indexierung zusammen und wählt daraus eine kanonische URL aus. Welche URL bevorzugt werden soll, könnt ihr Google mit verschiedenen Signalen mitteilen, zum Beispiel mit einem Canonical-Tag, Weiterleitungen, internen Links oder der XML-Sitemap. Die endgültige Auswahl trifft jedoch Google selbst. Die von euch angegebene Canonical-URL ist dabei ein wichtiges Signal, aber keine verbindliche Anweisung.
Duplicate Content bedeutet dabei nicht automatisch, dass eine Website von Google abgestraft wird. Ein gewisses Maß an doppelten Inhalten ist auf vielen Websites normal und stellt laut Google keinen Verstoß gegen die Spamrichtlinien dar. Das gilt beispielsweise für technisch erzeugte URL-Varianten. Google entscheidet bei sehr ähnlichen Seiten, welche URL als kanonische Version verwendet wird und in der Regel in den Suchergebnissen erscheinen soll.
Aus SEO-Sicht kann Duplicate Content vor allem dann problematisch werden, wenn die von Google ausgewählte kanonische URL nicht mit der von euch bevorzugten URL übereinstimmt. Das kann unter anderem passieren, wenn eine Website widersprüchliche Signale sendet, etwa wenn das Canonical auf URL A verweist, die XML-Sitemap und interne Links aber URL B bevorzugen. Genau das war bei unserem Praxiscase ein wesentlicher Teil des Problems. Google berücksichtigt diese Signale bei der Kanonisierung.
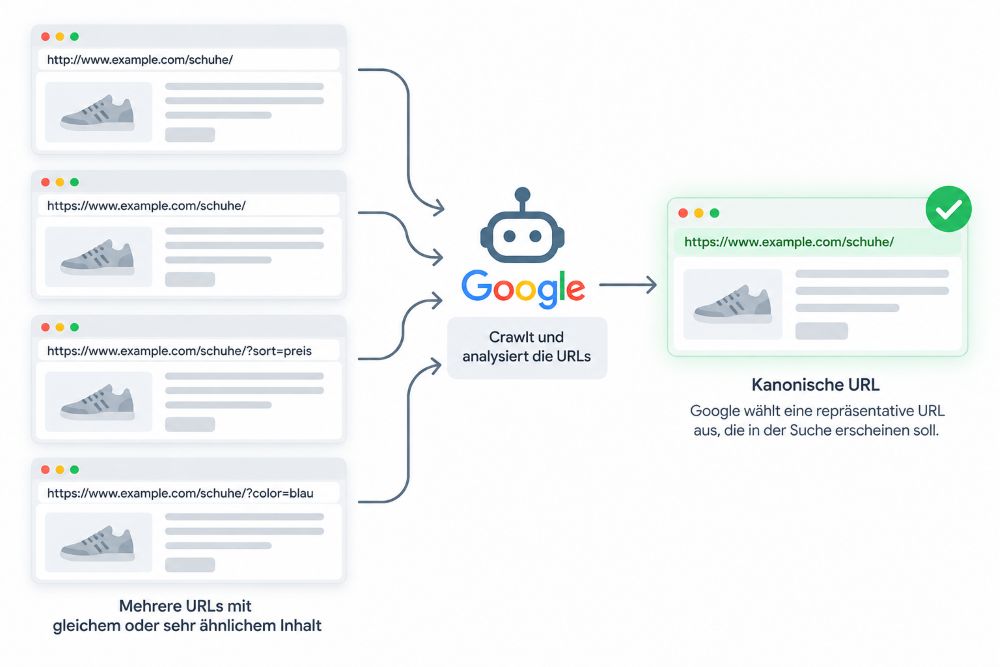 Bei identischen oder sehr ähnlichen Seiten versucht Google, eine repräsentative kanonische URL zu bestimmen.
Auswirkungen auf Rankings und Indexierung
Diesem Artikel liegt die Analyse einer Brand-Website zugrunde. Neben der Vorstellung der aktuellen Produkte ist auch ein Onlineshop integriert. Inhalte werden für über 60 Länder und Sprachen ausgespielt und sind auf einer globalen .com-Domain mit Land-Sprach-Verzeichnissen angelegt, zum Beispiel www.domain.com/de-de/. Zum Zeitpunkt der ursprünglichen Analyse im Oktober 2016 waren 270.000 URLs im Google Index vorhanden. Im /de-de/-Verzeichnis gab es 23.000 URLs. Um das Ganze etwas einfacher zu halten und weil der Kernmarkt des Herstellers Deutschland war, haben wir uns vor allem die deutschen Inhalte angesehen.
Duplicate Content muss nicht zwangsläufig zu Rankingverlusten führen. Problematisch wird es vor allem dann, wenn Google nicht die gewünschte URL priorisiert oder durch widersprüchliche Signale unnötig viele Varianten crawlt und indexiert. Dadurch können nicht gewünschte URL-Varianten in den Suchergebnissen erscheinen, die Auswertung der organischen Performance erschwert werden oder sich die Indexierung größerer Website-Bereiche anders entwickeln als vorgesehen. Wie deutlich sich solche Effekte zeigen können, wurde in unserem Praxiscase sichtbar.
Praxiscase: Sichtbarkeits- und Trafficverluste
Bei der untersuchten Website zeichnete sich ein negativer Trend in der Sichtbarkeit ab. Dies begann im Dezember 2015, nahm aber ab April 2016 verstärkt zu. Der Sistrix Sichtbarkeitsindex zeigte für Deutschland einen deutlichen Rückgang. Die Entwicklung betraf nicht nur die deutschen Inhalte, sondern zeigte sich auch in weiteren Sprach- und Länderversionen, unter anderem in Frankreich, Spanien, UK und den USA.
 Rückgang der Sichtbarkeit in Deutschland. Historischer Praxiscase aus 2016.
Die Entwicklung der Sichtbarkeit ist nicht immer ausschlaggebend für die Performance einer Website. Schließlich können auch ausschließlich Keywords von einem Einbruch betroffen sein, die für das Angebot des Website-Betreibers uninteressant sind. Allerdings war das hier nicht der Fall. Auch Suchbegriffe, die im Fokus unserer Content-Optimierung standen, verloren deutlich an Positionen. Schließlich machte sich ab Mai der Rückgang der Rankings auch im SEO Traffic bemerkbar. Im Vergleich zum Vorjahr ging er um mehr als 15 Prozent zurück, obwohl er in den Monaten zuvor noch guten Zuwachs erhalten hatte.
 Dem Verlust wichtiger Rankings folgte ein Rückgang des SEO Traffics. Historischer Praxiscase aus 2016.
Technische Veränderungen an der Website wurden zu diesem Zeitpunkt nicht vorgenommen und auch auf die Anpassung der Inhalte ließ sich diese Entwicklung nicht zurückführen. Da wir schlechten Content als Fehlerquelle ausschließen konnten, sahen wir uns die Website unter technischen Gesichtspunkten genauer an. Dabei fielen vor allem die parallelen HTTP- und HTTPS-Versionen, die hreflang- und Canonical-Auszeichnungen sowie Duplicate Content über mehrere Domains hinweg auf.
Häufige Ursachen für Duplicate Content
Duplicate Content entsteht nicht nur dadurch, dass Texte bewusst mehrfach veröffentlicht werden. Häufig sind technische Strukturen dafür verantwortlich, dass derselbe oder ein sehr ähnlicher Inhalt unter mehreren URLs aufrufbar ist. Bei internationalen Websites und Onlineshops kann das schnell eine große Zahl von URLs betreffen.
Einige dieser Ursachen spielten bereits in unserem Praxiscase eine zentrale Rolle. Andere, beispielsweise URL-Parameter sowie Sortier- und Filterfunktionen, sind für viele heutige Shops und große Websites ebenfalls relevant. Google selbst nennt unter anderem Protokollvarianten, regionale Varianten sowie Sortier- und Filterfunktionen als typische Gründe für Duplicate Content.
HTTP und HTTPS
Ein Problem, das wir bereits identifiziert hatten, das zuvor aber nicht zu Sichtbarkeitsverlusten geführt hatte, bestand darin, dass die Website sowohl unter HTTP als auch HTTPS erreichbar war. Da die Serverleistung laut IT-Abteilung zu diesem Zeitpunkt nicht ausreichend war, konnte die Website nicht komplett auf HTTPS umgestellt werden. Es konnten keine Weiterleitungen von HTTP auf HTTPS eingerichtet werden.
Abgesehen von dem Login-Bereich und den Seiten mit Kontaktformular zeigte bei den übrigen Unterseiten jeweils ein Canonical-Tag auf die HTTP-Version der passenden Unterseite. Außerdem enthielt die XML-Sitemap ausschließlich HTTP-Seiten. So sollte Google deutlich gemacht werden, dass die HTTP-Version die bevorzugte Variante war, die auch indexiert werden sollte.
Ein Blick in den Verzeichnis-Bericht von Sistrix zeigte allerdings, dass dies nicht mehr richtig funktionierte und immer mehr HTTPS-Seiten rankten. Zu diesem Zeitpunkt waren bereits über ein Viertel der indexierten URLs HTTPS-Seiten.
 HTTP- und HTTPS-Versionen waren parallel in der Google-Suche sichtbar. Historischer Sistrix-Praxiscase aus 2016.
Aus heutiger Sicht ist dieser Teil des Cases anders einzuordnen. HTTP- und HTTPS-Versionen können weiterhin zu doppelten URL-Varianten führen. Eine Website sollte heute jedoch konsistent über HTTPS betrieben werden. Bei einer Umstellung sollten die HTTP-URLs auf die entsprechenden HTTPS-Versionen weiterleiten. Auch Canonicals, interne Links, XML-Sitemaps und gegebenenfalls hreflang-Verweise sollten auf die bevorzugten HTTPS-URLs zeigen. Mehr zur technischen Umsetzung findet ihr in unserem Ratgeber zur HTTPS-Umstellung.
Ergänzend kann eine site:-Abfrage helfen, sich einen schnellen Überblick über auffindbare URL-Varianten zu verschaffen. Wie ihr den Operator verwendet, erklären wir in unserem Beitrag zu Google-Suchoperatoren. Für die Prüfung der von Google ausgewählten kanonischen URL ist heute jedoch die URL-Prüfung in der Google Search Console aussagekräftiger.
URL-Parameter und URL-Varianten
Duplicate Content kann außerdem entstehen, wenn derselbe Inhalt über unterschiedliche URL-Varianten erreichbar ist. Das kommt besonders häufig bei Onlineshops vor. Filter- und Sortierfunktionen können beispielsweise zusätzliche URLs einer Kategorieseite erzeugen, obwohl der eigentliche Inhalt gleich oder sehr ähnlich bleibt. Auch Google nennt solche Websitefunktionen als typische Ursache für Duplicate Content.
Ein einfaches Beispiel ist eine Produktkategorie unter /schuhe/, die über eine Sortierfunktion zusätzlich unter /schuhe/?sort=preis erreichbar ist. Ändert sich dadurch im Wesentlichen nur die Reihenfolge der Produkte, entstehen zwei URLs mit sehr ähnlichem Hauptinhalt.
Ein vergleichbares Problem gab es bereits im ursprünglichen Praxiscase. Dort wurden Canonicals eingesetzt, weil Produkte unter unterschiedlichen Kategorien gelistet wurden und dadurch Duplicate Content entstand. Ob ein Canonical, eine Weiterleitung oder eine andere technische Lösung sinnvoll ist, hängt davon ab, ob die zusätzliche URL weiterhin benötigt wird. Mehr zur Umsetzung findet ihr in unserem Artikel zu Canonical Tags.
Domainübergreifende Inhalte
Ursprünglich lagen die unterschiedlichen Sprachversionen der Inhalte der Website auf den entsprechenden Länder-Domains des Herstellers. Nach einem Relaunch Ende 2013 wurden sie auf der .com-Domain zusammengefasst und in Land-Sprach-Verzeichnissen untergebracht. Die alten Domains wurden korrekt per 301-Redirect auf diese Verzeichnisse weitergeleitet. Soweit sah das erst einmal gut aus.
Allerdings traf dies nur auf die HTTP-Version der Länder-Domains zu. Die HTTPS-Variante war immer noch erreichbar und wurde auch indexiert. Beim Klick auf ein Suchergebnis wurde zwar eine Fehlermeldung eingeblendet, die darauf hinwies, dass die Website nicht sicher sei, aufrufen konnte man sie aber trotzdem und Google konnte sie auch crawlen und indexieren.
Bei einem genaueren Blick auf die Website stellte sich heraus, dass nicht nur die deutschen Inhalte auf der de-Domain aufrufbar waren, sondern auch alle anderen Inhalte in jeder Sprachversion, die auch auf der .com-Domain vorhanden waren. Entsprechende hreflang-Tags wurden hier ebenfalls verwendet.
Es gab also sehr viel domainübergreifenden Duplicate Content: Die Inhalte lagen nicht nur auf der .com-Domain und der de-Domain, sondern auch auf weiteren Länder-Domains in mehrfacher Form vor.
Gerade bei internationalen Websites können fehlerhafte Weiterleitungen, uneinheitliche URL-Strukturen oder falsche hreflang-Verweise schnell zu größeren SEO-Problemen führen. Weitere typische Stolperfallen zeigen wir in unserem Beitrag zu SEO-Fehlern bei internationalen Websites.
Internationale und regionale Inhalte
Internationale Websites sind ein Sonderfall, denn unterschiedliche Sprachversionen sind nicht automatisch Duplicate Content. Google betrachtet Sprachversionen dann als Duplikate, wenn der Hauptinhalt weiterhin in derselben Sprache vorliegt. Regionale Varianten in derselben Sprache, beispielsweise weitgehend gleiche Seiten für die USA und Großbritannien, können dagegen sehr ähnliche Inhalte aufweisen. Für solche Fälle nennt Google die Kombination aus Kanonisierung und hreflang.
Für internationale Websites ist deshalb zunächst entscheidend, welche Seiten als eigenständige Sprach- oder Länderversionen in der Suche erscheinen sollen. hreflang hilft Google dabei, diese Varianten dem passenden Land beziehungsweise der passenden Sprache zuzuordnen. Ein Canonical erfüllt dagegen eine andere Aufgabe und signalisiert, welche URL aus einer Gruppe identischer oder sehr ähnlicher URLs bevorzugt wird. Mehr zu den Grundlagen findet ihr in unseren Beiträgen zur Erstellung und Einbindung von hreflang-Tags und zu SEO für internationale Websites.
Wenn ihr internationale Websites strategisch und technisch sauber aufsetzen oder bestehende Setups prüfen möchtet, unterstützen wir euch außerdem im Bereich Internationales SEO Marketing.
Canonical und hreflang richtig einsetzen
Bei der untersuchten Website gab es ein weiteres Problem mit den hreflang-Angaben. Damit die Inhalte von Google dem richtigen Land und der richtigen Sprache zugeordnet werden konnten, verwiesen die hreflang-Tags jeweils auf die entsprechenden Sprachversionen. Gleichzeitig wurden Canonicals verwendet, da Produkte unter unterschiedlichen Kategorien gelistet wurden und so Duplicate Content entstand.
Die Kombination von Canonical und hreflang war dabei nicht grundsätzlich das Problem. Entscheidend war, dass die Auszeichnungen nicht konsistent aufeinander abgestimmt waren. Während die hreflang-Tags der HTTP-Seiten auf die vorgesehenen Sprachversionen verwiesen, führten die Angaben auf den HTTPS-Seiten teilweise zu anderen Länder-Domains. Dadurch entstanden widersprüchliche Signale für Google.
Was ein Canonical signalisiert
Mit einem Canonical könnt ihr Google mitteilen, welche URL ihr bei identischen oder sehr ähnlichen Inhalten als bevorzugte Version betrachtet. Das Canonical ist dabei ein wichtiges Signal, aber keine verbindliche Vorgabe. Google berücksichtigt bei der Kanonisierung weitere Hinweise, etwa Weiterleitungen, Sitemaps oder die verwendete HTTP-/HTTPS-Version.
Ein Canonical sollte deshalb nicht isoliert betrachtet werden. Wenn andere technische Signale eine andere URL bevorzugen, kann Google eine andere kanonische URL auswählen. Wie Canonicals aufgebaut und implementiert werden, erklären wir ausführlich in unserem Beitrag Was ist ein Canonical Tag?.
Canonical und hreflang kombinieren
Im Praxiscase lag bei den hreflang-Angaben noch ein ganz anderes Problem vor. Die hreflang-Tags der HTTP-URLs verwiesen richtig auf die entsprechenden Inhalte in den anderen Sprachen.
 Die hreflang-Tags der HTTP-Seiten verwiesen auf die entsprechenden Sprachversionen. Historischer Praxiscase aus 2016.
Auf den HTTPS-Seiten waren allerdings Tags hinterlegt, die auf eine deutsche Länder-Domain verwiesen:
 Die hreflang-Tags der HTTPS-Seiten verwiesen auf eine andere Domain. Historischer Praxiscase aus 2016.
Auf den anderen Sprachversionen sah dies ähnlich aus. Die hreflang-Tags zeigten ebenfalls auf die entsprechende Länder-Domain. Leider ließ sich nicht mehr nachvollziehen, wann genau es zu diesem Fehler gekommen war. Die Vermutung lag aber nahe, dass dies bei der Integration der hreflang-Tags geschah, die schon einige Zeit zurücklag.
Widersprüchliche Signale vermeiden
Obwohl die Canonicals und ein Teil der hreflang-Tags auf die HTTP-Version und andere hreflang-Tags auf eine HTTPS-Version einer anderen Domain verwiesen, wurden immer mehr HTTPS-Seiten der .com-Domain indexiert.
Aus heutiger Sicht ist gerade dieser Teil des Cases besonders interessant. Die Website sendete Google mehrere unterschiedliche Signale darüber, welche URLs relevant beziehungsweise bevorzugt waren. Canonicals zeigten in eine Richtung, hreflang teilweise in eine andere. Hinzu kamen HTTP- und HTTPS-Versionen, XML-Sitemaps und weiterhin erreichbare Länder-Domains.
Google berücksichtigt bei der Kanonisierung mehrere technische Signale. Dazu zählen unter anderem Weiterleitungen, Sitemaps, Canonicals sowie HTTP und HTTPS. Wenn diese nicht zusammenpassen, kann Google eine andere kanonische URL auswählen als die von euch bevorzugte. Welche URL Google tatsächlich als kanonisch betrachtet, könnt ihr heute für einzelne Seiten über die URL-Prüfung der Google Search Console kontrollieren.
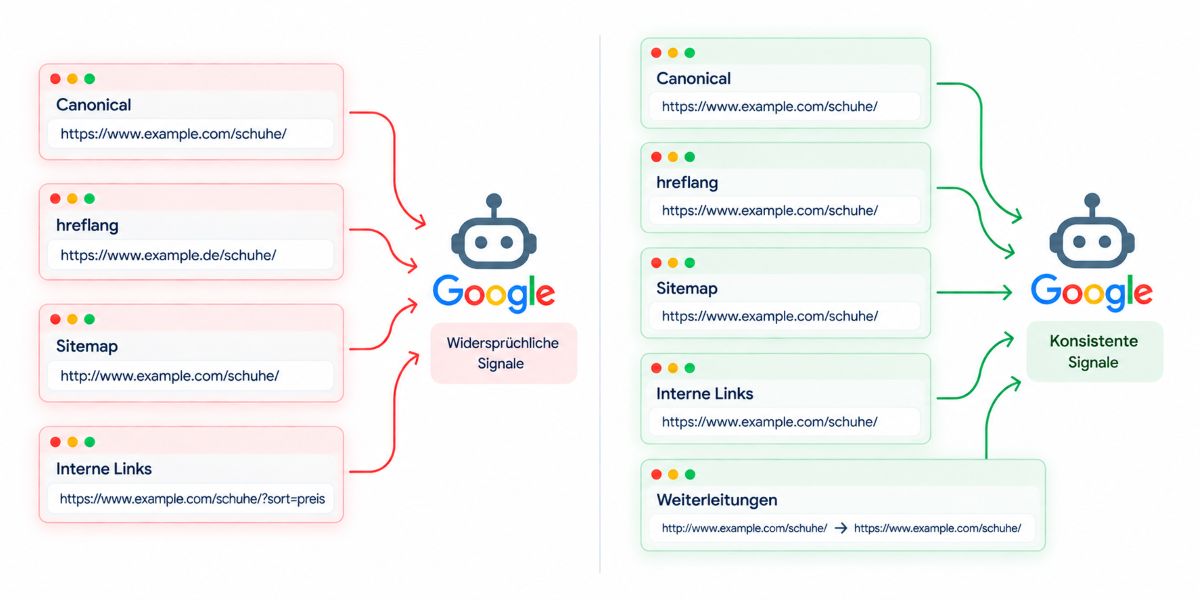 anonical, hreflang, Weiterleitungen, Sitemap und interne Links sollten keine widersprüchlichen URL-Signale senden.
Duplicate Content beheben
Um den Einbruch in der Sichtbarkeit schnellstmöglich zu stoppen und die Website wieder auf ihr vorheriges Level zu bringen, mussten die technischen Fehler behoben werden. Eine vollständige Umstellung auf HTTPS war zu diesem Zeitpunkt allerdings noch nicht möglich, da die technischen Voraussetzungen serverseitig nicht gegeben waren und ein Relaunch in absehbarer Zeit geplant war, bei dem diese Probleme behoben werden sollten.
Im ersten Schritt wurden deshalb folgende Maßnahmen umgesetzt:
- HTTPS-Versionen der alten Länder-Domains korrekt weitergeleitet.
- Canonical-Tags auf die jeweiligen HTTPS-Versionen angepasst.
- XML-Sitemaps auf HTTPS- statt HTTP-URLs umgestellt.
- hreflang-Tags korrigiert und Verweise auf Länder-Domains entfernt.
Teilweise blieben noch HTTP-Varianten bestehen, da eine vollständige Anpassung technisch nicht möglich bzw. zu aufwendig war. Die damaligen Maßnahmen lassen sich auch heute noch auf eine wichtige Grundfrage zurückführen: Welche URL soll bestehen bleiben und welche Aufgabe haben die übrigen Varianten? Davon hängt ab, wie Duplicate Content am sinnvollsten behandelt wird.
| Situation | Passende Maßnahme |
| Eine alte oder überflüssige URL wird dauerhaft nicht mehr benötigt | 301-Weiterleitung auf die passende Ziel-URL |
| Mehrere identische oder sehr ähnliche URLs müssen erreichbar bleiben | Canonical auf die bevorzugte URL |
| Es gibt eigenständige Sprach- oder Regionalvarianten | hreflang zur Zuordnung der Varianten |
| Canonical, Sitemap, interne Links oder Redirects verweisen auf unterschiedliche URLs | Technische Signale vereinheitlichen |
Eine 301-Weiterleitung ist sinnvoll, wenn eine URL dauerhaft ersetzt wird und keinen eigenen Zweck mehr erfüllt. Bei einer Migration empfiehlt Google, alte URLs ihren jeweiligen neuen Ziel-URLs zuzuordnen und Weiterleitungen entsprechend einzurichten. Auch Canonicals, hreflang-Angaben und interne Links sollten anschließend auf die neuen URLs aktualisiert werden.
Ein Canonical bietet sich an, wenn mehrere identische oder sehr ähnliche URLs weiterhin erreichbar bleiben müssen, aber eine davon als bevorzugte Variante signalisiert werden soll. hreflang kommt dagegen bei eigenständigen Sprach- und Regionalversionen zum Einsatz und löst Duplicate Content nicht im eigentlichen Sinne.
Unabhängig von der gewählten Maßnahme gilt die wichtigste Erkenntnis aus unserem Case weiterhin: Weiterleitungen, Canonicals, interne Links, XML-Sitemaps und hreflang sollten eine konsistente URL-Strategie unterstützen.
Obwohl die Maßnahmen mit Blick auf den anstehenden Relaunch nur teilweise umgesetzt wurden, konnte der Abwärtstrend in der Sichtbarkeitsentwicklung vorerst gestoppt werden (Stand Ende Oktober 2016).
 Nach den ersten Optimierungsmaßnahmen konnte der Abwärtstrend vorerst gestoppt werden. Historischer Praxiscase, Stand Oktober 2016.
Ein Blick auf die Verzeichnis-Ebene zeigt zudem, dass sich die HTTPS-Variante im weiteren Verlauf deutlich durchsetzte, während die HTTP-Version ihre Sichtbarkeit nahezu vollständig verlor.
 Die HTTPS-Version gewann deutlich an Sichtbarkeit, während die HTTP-Version ihre Sichtbarkeit verlor. Historischer Sistrix-Praxiscase aus 2016.
Was der Praxiscase heute zeigt
Ein Blick auf die damalige Entwicklung zeigt, wie wichtig ein richtiges Konzept für die Auszeichnung internationaler Inhalte ist. Falsch ausgerichtete Canonicals, widersprüchliche hreflang-Tags und parallel erreichbare URL-Versionen können dazu führen, dass Suchmaschinen nicht eindeutig erkennen, welche Seiten indexiert und in den Suchergebnissen ausgespielt werden sollen. Der Praxiscase zeigte außerdem, dass sich solche Probleme nicht unbedingt auf einzelne URLs beschränken, sondern bei großen internationalen Websites schnell tausende Seiten betreffen können.
Auch wenn sich einzelne technische Rahmenbedingungen und Möglichkeiten zur Fehlersuche seit dem ursprünglichen Praxiscase verändert haben, bleibt die zentrale Erkenntnis bestehen: Nicht ein einzelnes Canonical oder hreflang-Tag war das eigentliche Problem. Entscheidend waren die widersprüchlichen Signale über viele URLs hinweg.
Darum ist es wichtig, solche Entwicklungen früh zu erkennen und ihnen entgegenzuwirken. Wenn Google eine andere URL als kanonisch auswählt als erwartet, lohnt sich nicht nur der Blick auf das Canonical selbst. Weiterleitungen, interne Links, Sitemap, Protokoll- und Domainvarianten sowie bei internationalen Websites die hreflang-Auszeichnungen sollten gemeinsam geprüft werden. Google empfiehlt bei Problemen mit der Kanonisierung ebenfalls, sowohl die ausgewählte kanonische URL als auch mögliche technische Fehlkonfigurationen zu untersuchen.
Häufige Fragen zu Duplicate Content
Ist Duplicate Content eine Google Penalty?
Nein. Duplicate Content führt nicht automatisch zu einer Abstrafung durch Google. Eine gewisse Menge doppelter Inhalte ist laut Google normal und verstößt nicht gegen die Spamrichtlinien. Google versucht bei identischen oder sehr ähnlichen Seiten vielmehr, eine repräsentative kanonische URL auszuwählen.
Wann wird Duplicate Content zum SEO-Problem?
Problematisch kann Duplicate Content werden, wenn Google nicht die gewünschte URL als kanonische Version auswählt oder wenn verschiedene technische Signale unterschiedliche URLs bevorzugen. Das kann insbesondere bei sehr vielen URL-Varianten, falsch gesetzten Canonicals, unvollständigen Weiterleitungen oder internationalen Websites relevant werden.
Braucht jede Seite ein Canonical?
Nicht jeder Duplicate-Content-Fall muss über ein Canonical gelöst werden. Wird eine URL dauerhaft nicht mehr benötigt, kann eine Weiterleitung sinnvoller sein. Bleiben mehrere ähnliche URLs bewusst erreichbar, kann mit einem Canonical eine bevorzugte Version signalisiert werden.
Sind Sprachversionen Duplicate Content?
Unterschiedliche Sprachversionen gelten nicht automatisch als Duplicate Content. Google betrachtet sie als Duplikate, wenn der Hauptinhalt in derselben Sprache vorliegt und beispielsweise nur Navigation oder andere weniger wichtige Elemente übersetzt wurden. Bei regionalen Varianten in derselben Sprache können Kanonisierung und hreflang gemeinsam eingesetzt werden.
Wie finde ich Duplicate Content auf meiner Website?
Bei einzelnen URLs könnt ihr mit der URL-Prüfung der Google Search Console kontrollieren, welche URL Google als kanonisch ausgewählt hat. Bei größeren Websites sollten zusätzlich URL-Varianten, Canonicals, Weiterleitungen, interne Links, XML-Sitemaps und gegebenenfalls hreflang-Auszeichnungen systematisch gecrawlt und miteinander verglichen werden.
Können Canonical und hreflang zusammen eingesetzt werden?
Ja. Canonical und hreflang haben unterschiedliche Aufgaben und können gemeinsam eingesetzt werden. Das Canonical unterstützt Google bei der Auswahl einer repräsentativen URL für identische oder sehr ähnliche Inhalte. hreflang hilft dabei, Sprach- und Regionalvarianten richtig zuzuordnen. Wichtig ist, dass beide Auszeichnungen zur gewünschten URL- und Internationalisierungsstrategie passen.